狗狗衔取训练,固定时间强化稳定性,轻松学会猎物寻回
建立衔取本能与初始互信
衔取训练的核心并非简单的“拿来”,而是将狗狗对移动物体的追逐本能转化为可控的服从性行为。许多初学者常犯的错误是在狗狗兴奋度不足时强行介入,或者使用带有压迫感的动作,这会导致狗狗对玩具产生厌恶而非渴望。科学的起点是利用高价值奖励(如高气味零食或特定的发声玩具)激发其捕猎驱动力,通过“给予-交换”的机制,让狗狗明白吐出物品能获得更优越的回报,从而建立起基础的交易逻辑。
在初期阶段,固定时间的训练能极大提升狗狗的专注度与预期管理。人类与犬类的生物钟存在差异,选择狗狗精力充沛且情绪稳定的时段(通常为饭后1-2小时或晨间活动后),每次训练控制在5-10分钟,有助于维持其心理兴奋阈值。当狗狗能稳定衔取指定物品并在听到口令时松开,即完成了从“本能追逐”到“条件反射”的第一步,为后续复杂的环境干扰训练打下生理与心理基础。
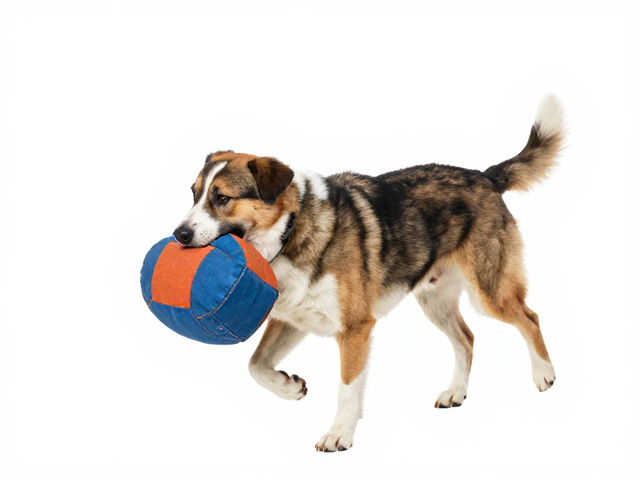
利用固定节奏强化行为稳定性
行为的稳定性来源于可预测的奖励机制,固定时间强化是建立这一机制的关键手段。在训练过程中,设定为每成功完成一次衔取动作后,立即给予等时的奖励或短暂的互动游戏,这种即时反馈能显著缩短狗狗大脑中“动作”与“愉悦结果”之间的神经连接路径。若延迟奖励或随机奖励,狗狗容易产生困惑,导致行为链条断裂,表现为犹豫、拖延或完全拒绝配合。
固定时间还体现在训练周期的规律性上。例如,每日同一时间段进行同一项衔取练习,能利用环境线索(如光线、气味、主人的特定动作前奏)触发狗狗的从属状态。这种规律性降低了狗狗的认知负荷,使其在无需过度思考的情况下自动进入工作状态。通过数周甚至数月的重复,这种固定的时间节奏会内化为狗狗的行为习惯,即使在没有即时互动的时刻,其衔取动作的规范度和速度也会因肌肉记忆和条件反射的固化而保持高位稳定。
模拟真实场景应对动态干扰
当基础衔取动作在静态环境下已能完美呈现,训练重心需转移至动态干扰与场景模拟。猎物寻回的本质是在复杂环境中快速定位并回收目标,因此需引入移动物体(如拖拽的布偶、滚动的球)和次要干扰源(如轻微的人声、其他宠物经过)。在此阶段,固定时间的强化表现为对“完成动作”这一整体流程的评估,而非单一动作的奖励,确保狗狗在受到干扰后仍能迅速回归任务核心。
通过逐步增加环境变量的难度,如扩大搜索范围、增加障碍物或引入时间压力,狗狗的寻回策略会从“盲目扑咬”进化为“精准定位”。此时,固定时间强化的逻辑转变为对“决策速度”和“准确性”的固化。每一次在干扰下成功完成寻回,都是一次对神经回路抗压能力的加固。这种经过动态环境洗礼后的稳定性,使得狗狗在面对真实狩猎或户外拾取场景时,能保持极高的执行效率,不因外界突发状况而偏离既定行为模式。