正向强化原理,训导理论入门,巧用玩具奖励打造高效训练
正向强化的核心逻辑与行为塑造机制
正向强化是行为心理学中的基础概念,源于斯金纳的操作条件作用理论。其核心在于在目标行为发生后立即给予个体偏好的刺激,从而增加该行为在未来发生的频率。这种机制不依赖于惩罚或压制,而是通过建立“行为-奖励”的紧密联结,让受训对象主动理解并重复正确动作。在动物训练或习惯养成中,关键在于奖励的即时性,延迟奖励会削弱行为与奖励之间的因果关联,导致学习效果大打折扣。
实施正向强化需要精准识别个体的“高价值奖励”。对于大多数犬类而言,食物通常是最高效的强化物,但高运动需求或猎犬基因的个体可能更受玩具或抚摸驱动。训练者需观察受训对象在自然状态下的偏好,选择能引发其强烈多巴胺分泌的刺激源。当奖励物能激发受训对象的热情与专注时,学习效率会呈指数级提升,这种内在动机的唤醒比外在强制更为持久且稳定。
玩具奖励在训练中的实操策略
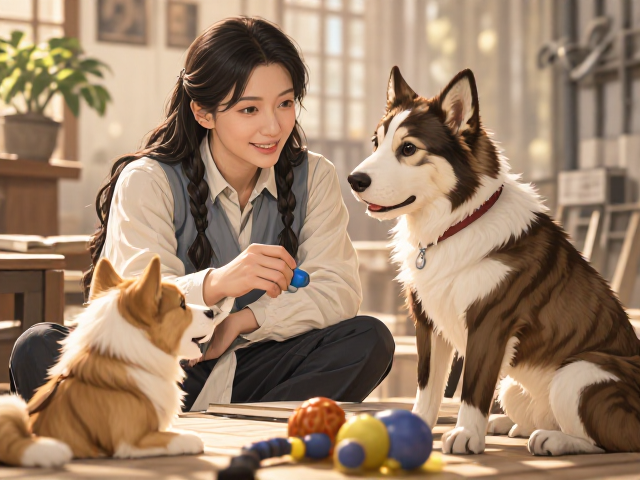
使用玩具作为奖励工具时,必须建立严密的“工作-游戏”转换机制。训练初期,应在受训对象完成指定动作(如坐下、握手或召回)的瞬间,立即用玩具激发其捕猎或追逐本能。例如,在训练犬只召回时,当犬只跑回训练者身边,立刻抛出逗猫棒或飞盘,使其将“快速返回”与“获得快乐游戏”直接挂钩。这种动态奖励能极大提升训练的趣味性,尤其适用于注意力易分散或低动机水平的受训对象。
玩具互动的节奏控制是维持训练效率的关键。训练者需掌握“间歇性强化”的技巧,并非每次动作都给予长时间游戏,而是通过短促、高频互动的玩具抛接或拉扯游戏作为即时反馈。这种模式能保持受训对象的高昂情绪状态,同时避免过度兴奋导致动作变形。在实际操作中,建议将玩具互动控制在10-30秒以内,迅速回归平静状态进行下一轮指令,形成清晰的训练闭环,防止受训对象因过度兴奋而无法执行后续指令。
常见误区与效率优化技巧
许多初学者常犯的错误是在奖励阶段过度延长游戏时间,导致受训对象情绪过载,难以从兴奋状态切换回服从状态。这种“奖励失控”会使训练变得冗长且低效。正确的做法是设置明确的结束信号,例如在玩具游戏中途突然静止,待受训对象注意力重新聚焦于训练者后,方可继续或结束本次训练单元。这种控制感训练有助于培养受训对象对训练者的专注度,而非仅仅是对玩具的单向渴望。
此外,玩具奖励需与口头指令和手势信号同步,避免形成单一刺激依赖。如果每次奖励都伴随相同的玩具抛掷动作,受训对象可能只对玩具的视觉或听觉信号做出反应,而忽略指令本身。因此,应在奖励互动的起始阶段加入清晰口令,让受训对象理解玩具是完成动作后的“奖赏”,而非互动的“起因”。通过逐步淡化玩具的视觉吸引力,强化口令与奖励之间的关联,最终实现仅凭口令即可引发正确行为的稳定效果。