狗狗闻东西不理人?用正向强化法近距离唤回,训练听口令
理解狗狗“闻嗅优先”的本能机制
狗狗的嗅觉系统极其发达,其嗅黏膜面积可达人类数倍,嗅觉受体数量更是远超人类,这使得它们在探索环境时会自然地将注意力高度集中在气味信息上。当狗狗专注于闻地上的某个气味源时,大脑中的奖赏回路被强烈激活,此时外界的声音指令往往会被视为干扰信息,而非互动的邀请。这种现象并非狗狗故意无视主人,而是生物本能驱动下的注意力分配结果,尤其在户外充满复杂气味刺激的环境中,这种本能表现更为显著。
面对这种情况,强行拉扯牵引绳或大声呵斥通常会导致狗狗产生防御心理或困惑,进而加剧其对主人的忽视。正向强化法的核心在于将“回应主人”转化为比“闻气味”更有趣、更有回报的行为,而不是通过惩罚来压制本能。通过建立正确的从属关系,让狗狗意识到关注主人能获得比路边气味更高级的价值,从而逐步重塑其行为模式,这是解决近距离唤回难题的基础逻辑。
构建高价值奖励与场景脱敏
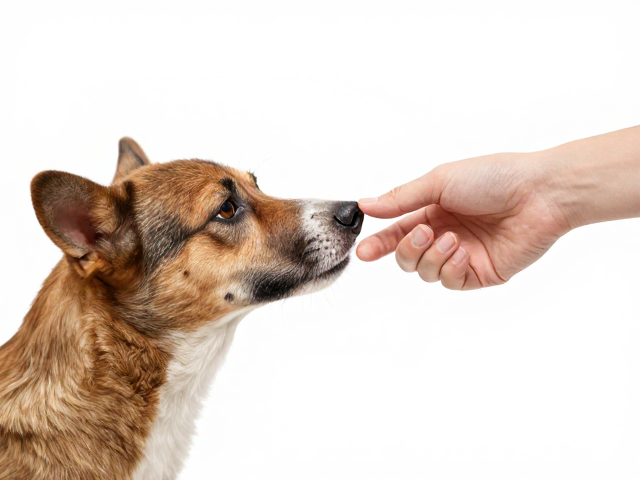
训练初期需要选择狗狗无法抗拒的高价值奖励,例如煮熟的鸡胸肉、奶酪块或特制的零食,这些食物的气味和口感能迅速激发狗狗的动力。在低干扰环境如家中或安静的客厅开始训练,让狗狗处于轻微兴奋但可控的状态。主人手持奖励,发出清晰简短的口令如“来”或“看我”,当狗狗目光或身体转向主人时,立即给予奖励并标记正确行为。这一过程旨在建立口令与高价值回报之间的直接神经联系,让狗狗明白回应指令能带来即时且确定的收益。
随着狗狗在低干扰环境下能稳定回应,需逐步增加难度,将训练场景迁移至干扰较多的户外区域,但始终保持距离可控。在狗狗开始注意周围气味但尚未完全沉浸时,提前介入并发出唤回指令。如果狗狗未能立即回应,不要重复口令,而是通过肢体语言或展示奖励重新吸引其注意。若狗狗完全沉浸其中,可等待其短暂抬头或眼神接触的瞬间,迅速给予奖励,逐步拉长从“闻嗅”到“回应”的时间窗口,避免让狗狗养成只对主人气味做出反应,而对声音指令脱敏的习惯。
强化近距离唤回与注意力锁定
在实际操作中,近距离唤回的关键在于时机把控与互动的趣味性。当狗狗在附近活动并表现出对环境好奇时,主人应保持轻松愉悦的状态,避免传递焦虑或紧张的情绪。使用带有期待感的语调发出唤回指令,同时配合蹲下、拍手或展示零食等动作,降低狗狗的压迫感。一旦狗狗转身靠近,立即给予热情的口头表扬和实物奖励,并短暂进行互动游戏,如轻抚或抛掷玩具,让“回到主人身边”成为一段愉快的体验,而非训练的结束或互动的中断。
为了巩固训练效果,需要设置不同的变式场景,避免狗狗形成条件反射式的机械回应。例如,在狗狗刚完成闻嗅动作的当下,立即在其视线范围内变换位置,发出唤回指令,迫使狗狗在动态中调整注意力焦点。每次成功唤回后,不要立即结束训练或继续行走,而是停留片刻,让狗狗在放松状态下确认与主人的联系。这种“唤回-奖励-互动-停留”的闭环训练,能有效提升狗狗在复杂环境中的注意力持续时间,使其逐渐习惯于在探索间隙主动寻求与主人的互动。
应对干扰与长期行为固化
在户外训练中,难免遇到其他动物、行人或强烈气味源等突发干扰,这些时刻是检验训练成果的关键节点。若狗狗因干扰而忽略指令,主人应保持冷静,避免情绪化反应。可以尝试使用更强烈的激励手段,如更高价值的零食或更具互动的玩具,重新夺回狗狗的注意力。若狗狗完全无法回应,需立即缩短牵引绳长度,通过物理引导辅助其完成动作,随后给予奖励,以此确保每次训练都以成功结束,逐步积累狗狗的成功经验。
长期来看,行为的固化依赖于一致性与重复,而非单次训练的强度。主人需将唤回训练融入日常散步中,使其成为自然的生活场景,而非独立的课程。即使在狗狗表现良好的阶段,也应不定期进行随机奖励,防止行为消退。通过持续观察狗狗的行为变化,灵活调整训练策略,逐步减少实物奖励的频率,转而依赖抚摸、拥抱或口头表扬等社会性奖励,最终实现狗狗在无零食辅助下,依然能因情感连接和习惯养成而稳定回应指令的目标。