犬只服从训练营,巧用零食奖励引导,让礼貌握手互动更自然高效
建立信任基础与正向反馈机制
在犬只行为训练中,零食奖励并非简单的食物交换,而是构建人犬之间信任纽带的核心工具。许多初学者常误以为只要食物足够诱人,狗狗就会无条件服从,实则不然。高价值零食的选择需要基于狗狗的个人偏好,例如对于对肉类敏感的犬只,煮熟的鸡胸肉或冻干牛肉往往比普通的狗粮块更具引导效力。这种个性化选择能显著降低训练过程中的干扰,使狗狗将“握手”这一动作与愉悦的奖励体验形成强关联。
正向反馈的时机把控直接决定了互动的自然程度。当犬只做出预期动作的瞬间,必须立即给予奖励,这种毫秒级的时间关联能帮助犬只精准理解行为与结果之间的逻辑。若延迟奖励,犬只可能会将注意力分散到周围的环境或其他无关动作上,导致训练效果大打折扣。通过精准的时间锁定,训练者能够逐步塑造出门槛极低的行为雏形,让每一次微小的进步都转化为可量化的成就感。
分解动作与引导互动的具体策略
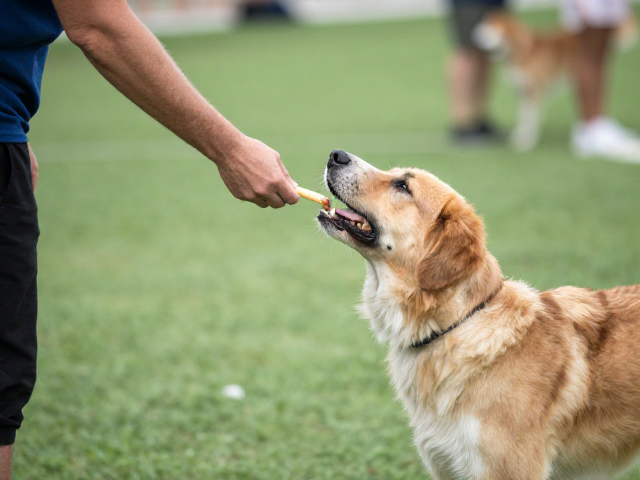
实施握手训练时,将复杂动作拆解为微小的步骤是提升效率的关键。一种常见且高效的方法是利用食物诱导法,训练者手持零食置于犬只胸前稍偏下的位置,当犬只为了触碰或嗅闻零食而自然抬起前肢时,立即标记该动作并给予奖励。这一过程不需要强行抬起犬只的腿,而是通过引导其自主完成动作,从而减少犬只的心理抵触。随着重复次数的增加,犬只会逐渐理解抬起爪子是获取奖励的唯一途径。
在犬只能稳定完成抬爪动作后,逐步引入口令与手势。此时,可以将原本用于诱导的零食从手中移至另一只手,仅保留手势或口头指令,待犬只做出反应后,从另一只手给予奖励。这种从“实物诱导”到“信号诱导”的过渡,有助于消除犬只对手中食物的过度依赖,使握手动作逐渐脱离对食物的即时渴求,转化为对指令的条件反射。通过反复练习,互动的流畅度会显著提升,犬只不再需要每次都看到食物才能做出反应。
场景泛化与长期互动的维持
训练成果的稳定存在需要经过不同场景的泛化检验。如果在安静的室内完成了握手训练,直接切换到嘈杂的公园或街道,犬只很可能因为环境干扰而遗忘动作。因此,训练者应逐步增加环境的复杂度,从安静的房间过渡到楼道,最终到达户外。每一次场景的转换都是一次新的学习过程,需要重新建立注意力焦点。通过在不同地点、不同时间段重复基础指令,犬只能够逐渐明白“握手”这一指令具有跨场景的一致性,从而在任何环境下都能做出稳定的回应。
日常互动的自然融入是维持训练成果的重要手段。除了专门的训练时段,主人可以在日常生活中随机触发握手指令,例如在打招呼、准备喂食或散步前后。这种非结构化的互动能让犬只感受到握手是一种社交礼仪,而不仅仅是任务。当犬只发现无论何时做出该动作都能获得主人的关注和抚摸,互动的内在驱动力便会增强。这种将训练融入生活的方式,使得礼貌握手成为一种自发且高效的沟通语言,而非机械化的条件反射。