多物品识别实战,模拟工作场景精准衔取指定物品
多物品识别在复杂仓储环境下的技术落地
在现代化的物流分拣中心或智能制造车间,自动化设备面临着海量且形态各异的物品处理需求。传统的单目标检测算法难以应对高密度堆放、遮挡严重以及类别差异巨大的实际场景,导致识别准确率下降和机械臂抓取失败率上升。引入多物品识别技术,旨在通过深度学习模型同时定位并分类画面中的多个独立物体,为后续的自动化执行单元提供精确的坐标与属性信息。这种技术路径直接回应了工业现场对于高吞吐量与高精度并重的核心诉求,是构建无人化作业闭环的关键一环。
技术实现层面,基于卷积神经网络的目标检测框架如YOLO系列或Faster R-CNN经过针对性优化,能够显著提升对微小物体及重叠物体的分割能力。通过收集包含不同光照条件、背景干扰以及物品堆叠状态的真实数据集进行训练,模型逐渐学会区分相似外观下的不同物品类别。在实际部署中,边缘计算设备负责实时推理,将识别结果以结构化数据形式输出,确保从视觉感知到动作执行的低延迟响应,从而满足快节奏生产线的稳定性要求。
模拟工作场景中的精准衔取策略
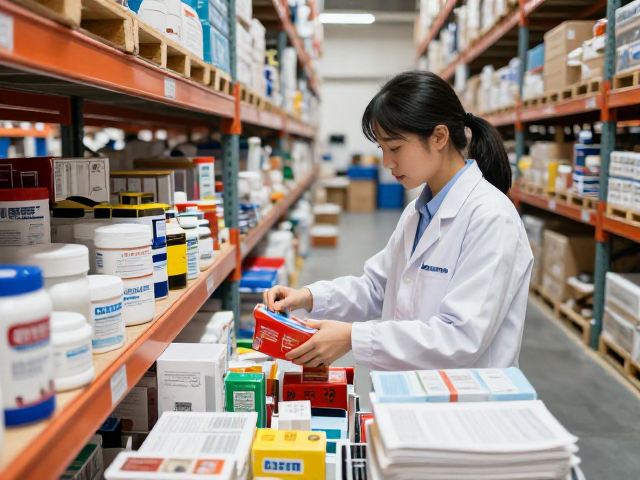
在模拟的电商仓库拣选场景中,自动化系统需要处理从纸箱、塑料瓶到不规则形状五金件等多种物品。当视觉系统检测到目标区域存在多个物品时,算法需结合深度相机获取的三维信息,计算每个物品的位姿矩阵。这一过程不仅包括二维边界框的定位,更涉及三维空间坐标的解算,以确定机械臂末端执行器的最佳接近点和抓取姿态。通过多物品识别模型输出的置信度过滤与非极大值抑制(NIM)处理,系统能够剔除误检,保留高可靠性的目标实例,为后续规划提供干净的数据源。
精准衔取的核心在于视觉反馈与运动控制的紧密耦合。在执行抓取动作前,系统会根据识别出的物品类别匹配相应的夹爪策略或真空吸盘参数。例如,对于表面光滑的玻璃制品,需调整吸附力以防破裂;对于易碎物品,则需规划更柔和的接近轨迹。通过反复迭代测试,验证不同物品在复杂堆叠状态下被成功分离并放置至传输带的成功率,确保系统在面对突发干扰如物品滑动或位置偏移时,仍能通过实时重规划保持作业的连续性与稳定性。
数据闭环与模型迭代优化
高质量的数据是维持多物品识别模型长期有效性的基石。在实际运行过程中,系统会自动记录识别失败或置信度较低的案例,形成难例样本库。这些样本经过人工标注或半自动标注后,被重新注入训练集,用于模型的增量学习或微调。通过持续引入新出现的物品类别或极端场景数据,模型能够不断扩展其泛化能力,适应不断变化的库存结构和环境变化。这种数据闭环机制避免了模型随着时间推移出现的性能衰减,确保其在长期服役期间保持较高的识别精度。
除了数据层面的优化,模型结构的轻量化与部署效率的提升也是工程实践中的重要环节。为了在资源受限的边缘设备上实现实时推理,研究人员常采用模型剪枝、量化以及知识蒸馏等技术,在牺牲极少量精度的前提下大幅降低计算开销。通过对比不同优化策略下的推理速度与准确率指标,确定最适合当前硬件平台的技术路线。同时,建立严密的测试基准,定期评估模型在真实工作流中的表现,确保每一次迭代都能带来可量质的提升,而非停留在理论层面的改进。